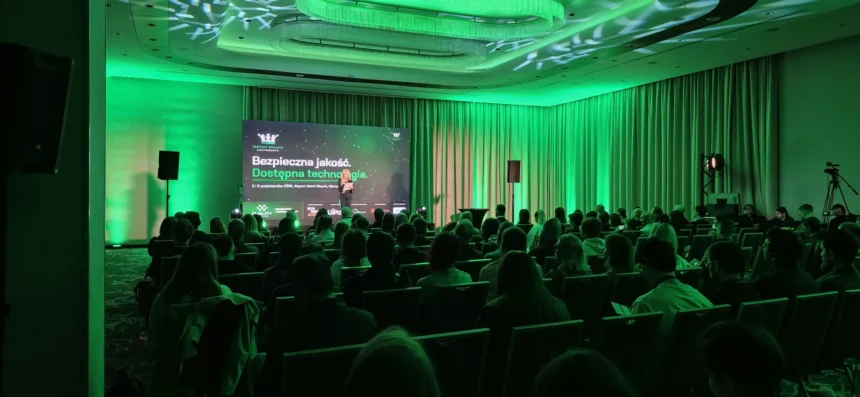
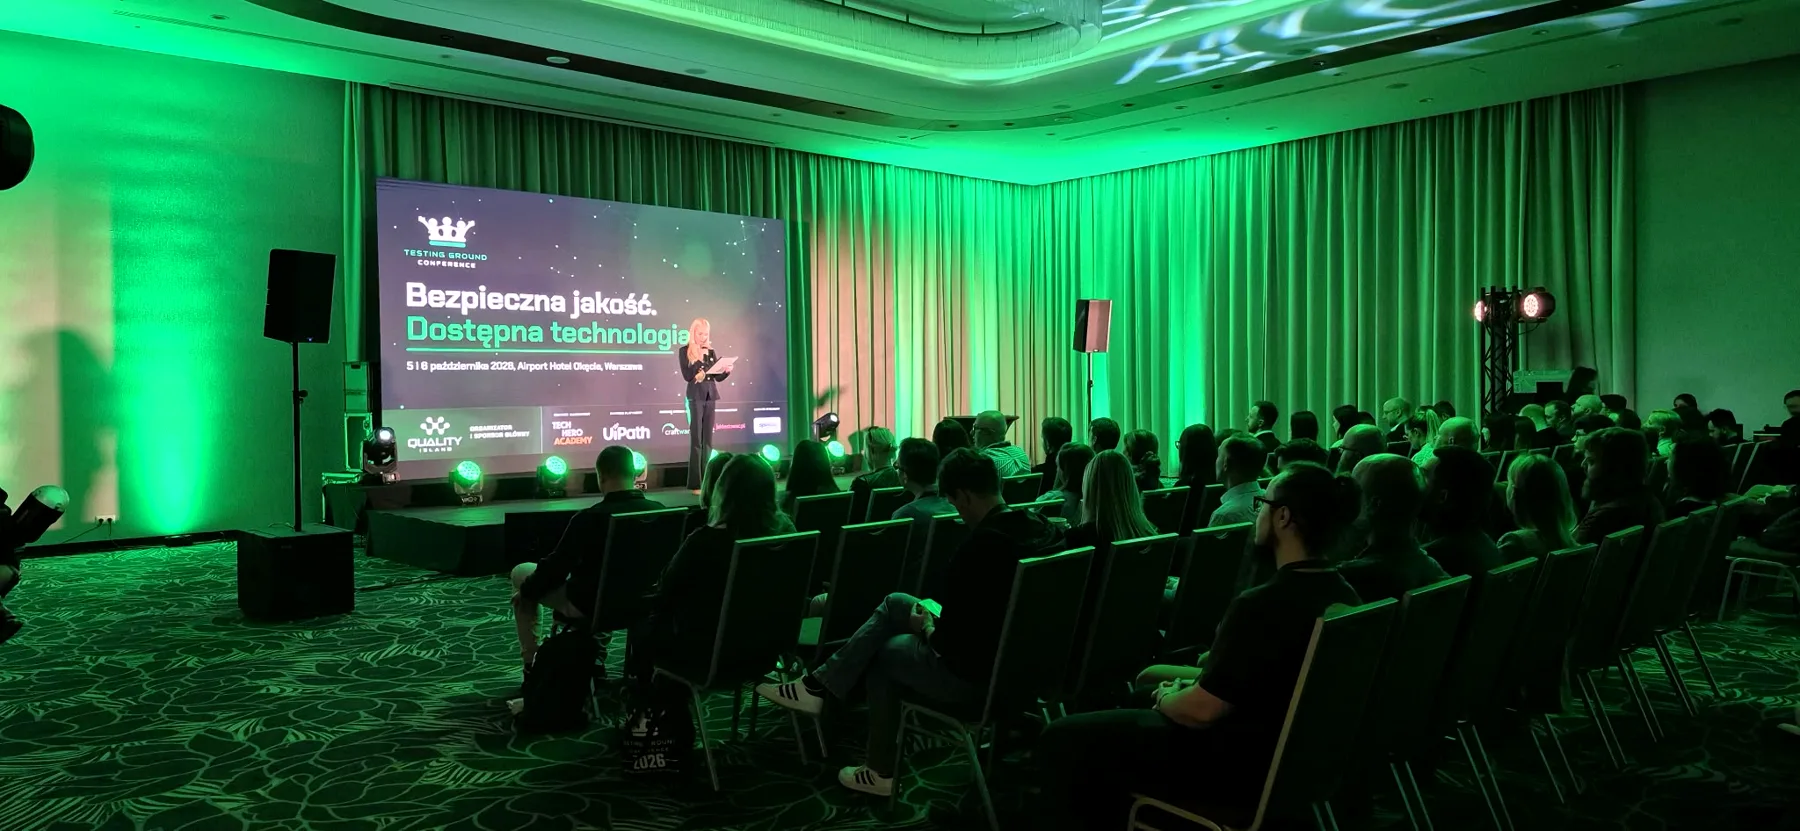
Testing Ground Conference 2026 za nami. Organizatorem i sponsorem głównym konferencji jest Quality Island, a jej pomysłodawcą i gospodarzem Tomasz Stelmach. 5 i 6 października w Airport Hotel Okęcie w Warszawie spotkało się ponad 350 uczestników. Byli wśród nich testerzy, inżynierowie testów i programiści testów, ale też szefowie działów testów i jakości oprogramowania, CTO oraz osoby decyzyjne z firm, którym zależy na jakości, bezpieczeństwie i dostępności ich oprogramowania i produktów cyfrowych. Hasło edycji brzmiało „Bezpieczna jakość. Dostępna technologia” i dobrze opisuje to, o czym mówiło się na scenach, na warsztatach i w kuluarach.
- Konferencja dla praktyków i dla biznesu jakości
- Relacja wideo z Testing Ground Conference 2026
- Trzy fronty jednej edycji: AI, bezpieczeństwo, dostępność
- Dzień pierwszy, 5 października: warsztaty
- Dzień drugi, 6 października: prelekcje na dwóch scenach
- Kto stoi za Testing Ground Conference
- Co wynosimy z edycji 2026
- Testing Ground Conference 2027: do zobaczenia w maju w Warszawie
- Powiązane
W tym materiale zebraliśmy wszystko w jednym miejscu: relacje wideo, pełną listę warsztatów i prelekcji z opisami oraz nasze wnioski z dwóch dni konferencji. Jeśli nie było Was w Warszawie, potraktujcie to jako mapę tematów, którymi branża QA żyje jesienią 2026 roku. Jeśli byliście, znajdziecie tu ściągę z sesji, na które nie zdążyliście.
Konferencja dla praktyków i dla biznesu jakości
Testing Ground Conference od początku jest projektowana na dwa poziomy rozmowy. Pierwszy to praktyka: warsztaty, kod, narzędzia i konkretne techniki testowania. Drugi to biznes QA, czyli miejsce, w którym spotykają się osoby odpowiedzialne za decyzje o jakości: szefowie działów testów i jakości oprogramowania, Head of QA, CTO, kierownicy IT oraz właściciele produktów cyfrowych.
Dla tej grupy jakość to nie lista przypadków testowych, tylko decyzja biznesowa. Liczą się ryzyko i koszt błędów na produkcji, przewidywalność wydań, wymogi NIS2 i KSC w obszarze bezpieczeństwa oraz Europejski Akt o Dostępności, który zamienił dostępność cyfrową w obowiązek prawny. Dlatego w agendzie obok sesji technicznych znalazły się prelekcje o governance i strategii testów, o zarządzaniu jakością w dużej organizacji i o tym, dlaczego bezpieczeństwo musi zacząć się przed pentestem.
- dla zespołów testerskich, inżynierów testów i programistów testów, którzy chcą wrócić z gotowymi technikami do wdrożenia,
- dla szefów działów testów i jakości oprogramowania, którzy układają proces QA w całej organizacji,
- dla CTO i osób decyzyjnych, którym zależy na jakości, bezpieczeństwie i dostępności oprogramowania oraz produktów cyfrowych,
- dla firm z sektorów regulowanych, w których jakość i niezależne testy są wymogiem, a nie wyborem.
Relacja wideo z Testing Ground Conference 2026
Najkrócej o tym, jak wyglądała tegoroczna edycja, opowiada główna relacja. Prelekcje, dzień warsztatów, stoiska partnerów, rozmowy przy kawie i finał z nagrodami zmieściły się w niecałych trzech minutach.
Krótsze formy z poszczególnych momentów konferencji znajdziecie niżej. To pionowe filmy, które najlepiej oglądać na telefonie.


Trzy fronty jednej edycji: AI, bezpieczeństwo, dostępność
Gdyby trzeba było streścić agendę jednym zdaniem: sztuczna inteligencja weszła do codziennej pracy testera, a razem z nią wróciły pytania o zaufanie, bezpieczeństwo i dostępność. Prawie każda sesja dotykała przynajmniej jednego z tych tematów, a najciekawsze rozmowy działy się na ich styku.
AI przestała być tematem pokazowym. Agenci testowi, Playwright z Claude Code i Cursorem, MCP, harnessy dla agentów i koszty tokenów. Prelegenci mówili mniej o tym, co AI potrafi w demo, a więcej o tym, co się psuje w projekcie ze 150 tysiącami linii kodu i jak to kontrolować.
Bezpieczeństwo przesuwa się w lewo. Pentest przed wdrożeniem jest najdroższym miejscem na znalezienie podatności. Kilka sesji pokazywało, jak wpisać bezpieczeństwo w wymagania, w Definition of Done i w codzienne testy, a NIS2 i KSC przenoszą odpowiedzialność na zarząd i na dostawców.
Dostępność cyfrowa to już obowiązek, nie dodatek. Europejski Akt o Dostępności obowiązuje od czerwca 2025 roku, a WCAG 2.2 dokłada kryteria, które tester sprawdzi bez skryptów. Trzy prelekcje i warsztat dotyczyły dostępności, w tym uczciwej oceny, ile z tej pracy może przejąć AI.
Dzień pierwszy, 5 października: warsztaty
Poniedziałek należał do praktyki. Osiem całodniowych warsztatów, laptopy na stołach, kod pisany na żywo i ćwiczenia na przygotowanych aplikacjach. Tak wyglądał program.
Testy Playwright napędzane AI: od agentów E2E po inteligentne testy API
Radosław Wasik, rwasik.pl i STATSCORE
Generowanie i modyfikowanie testów E2E i API z pomocą AI na frameworku Playwright. Uczestnicy pracowali z agentami testowymi oraz narzędziami MCP i Stagehand, wykorzystywali AI do testów dostępności, danych testowych i walidacji logiki, a na koniec łączyli to wszystko z CI/CD i omawiali, jak utrzymywać testy wygenerowane przez model.
AI w pracy testera: od frameworków promptowych do workflowów multi-agentowych
Grzegorz Holak i Konrad Gomulski, Sii Polska
Warsztat zaczął się od krótkiego self-checku poziomu pracy z AI, a potem przeszedł przez całą skalę adopcji: frameworki promptowe, świadomą pracę z kontekstem i workflowy z wieloma agentami. W centrum były codzienne zadania testera, czyli analiza wymagań, projektowanie testów, generowanie danych i wsparcie automatyzacji. Uczestnicy wyszli z dodatkowymi ćwiczeniami i planem dalszego rozwoju.
Cursor + Playwright = zrobiło się poważnie
Michał Wilkowski, Inetum Polska
Opowieść praktyka, który długo bronił się przed AI, a dziś nie wyobraża sobie powrotu do ręcznego pisania testów automatycznych. Pół roku temu generował godzinami „takie sobie” testy, teraz robi to szybko, bo nauczył się z modelem współpracować. Na warsztacie padło też pytanie, dlaczego AI jest jak smok i czy da się nad nim zapanować.
S.M.U.R.F. w praktyce: budowanie i optymalizacja testów Playwright
Krzysztof Kołodziejczyk, 21CN i Testerzy.pl
Jak przejść od testów flaky do reliable w Playwright i TypeScript. Warsztat opierał się na wzorcu AAA (Arrange, Act, Assert) i zasadach SMURF (Small, Maintainable, Understandable, Repeatable, Fast). Były typowane fixtures, bezpieczny teardown, testy API i scenariusze API plus UI z APIRequestContext, seedowanie danych, selective mocking, a także paralelizacja, sharding w CI oraz praca z trace, zrzutami i wideo. Uczestnicy dostali checklistę SMURF do code review.
Szybki feedback w CI/CD: pipeline, który buduje, testuje i wdraża bez utraty jakości
Tomasz Klepacki, Jit Team
Uczestnicy dostali aplikację demonstracyjną i workflow w GitHub Actions, który uruchamiał wszystko po kolei. Krok po kroku przebudowali go w pipeline z buildem, lintingiem, typecheckiem, skanem bezpieczeństwa oraz testami jednostkowymi, API i UI. Szybkie kontrole idą jako pierwsze, kosztowne testy UI uruchamiane są selektywnie, a do tego fail-fast, smoke testy dla pull requestów, raporty, artefakty i shardowanie bez dodatkowej infrastruktury w chmurze.
RiskStorming: odkrywanie strategii testów
Tomasz Jański, Wyższa Szkoła Kształcenia Zawodowego
Zamiast testować „wszystko po trochu”, uczestnicy uczyli się świadomie wybierać, co wymaga uwagi. Metodyka Risk Storming i talia kart TestSphere pomagają zespołowi wspólnie nazwać atrybuty jakościowe, zidentyfikować ryzyka, dobrać działania testowe i złożyć z tego strategię. Praca w grupach na realnym scenariuszu, dla juniorów i dla liderów QA, którzy chcą nauczyć tego swój zespół.
Agentic QA w dużych projektach
Kamil Iwanowicz, VIOOH, i Krystian Mikła, Test Automation Architect
Agent AI w krótkim demo robi wrażenie, w dużym projekcie często rozczarowuje. Prowadzący przeszli przez problemy z wdrożeń w projektach ze 150 tysiącami linii kodu i więcej. Uczestnicy zbudowali własny agent harness: dokumentację dla AI, selektywne wczytywanie kontekstu, orkiestrację z fazami, subagentami i pętlą feedbacku. Padła ważna teza, że zasada „więcej kontekstu, lepsze wyniki” nie zawsze działa.
Testowanie dostępności w 2026: co zrobi za Ciebie AI i jak to sprawdzić w praktyce
Katarzyna Basiewicz, Audyt dostępności
Wspólne case study dla wszystkich uczestników i porównanie trzech podejść na tej samej aplikacji. Najpierw klasyka: narzędzia automatyczne, takie jak axe, testy manualne i czytnik ekranu. Potem AI i agenci: generowanie scenariuszy, analiza dostępności i interpretacja wyników, łącznie z halucynacjami. Na koniec zestawienie AI, narzędzi i testera oraz checklista do codziennej pracy.
Wieczorem był czas na rozmowy: kameralna kolacja dla prelegentów, partnerów i uczestników z biletem EXCLUSIVE, a potem impreza integracyjna z DJ-em dla wszystkich.
Dzień drugi, 6 października: prelekcje na dwóch scenach
We wtorek program biegł równolegle w dwóch salach. Poniżej znajdziecie wszystkie prelekcje w kolejności z agendy.
Sala 1
Polityka i strategia testów jako elementy governance w organizacjach technologicznych
Grzegorz Holak, Sii Polska, i Filip Barszcz, Santander Corporate & Investment Banking · 09:40
Otwarcie merytoryczne dnia dotyczyło miejsca polityki i strategii testów w ładzie korporacyjnym organizacji technologicznych, czyli tego, jak jakość przestaje być sprawą jednego zespołu, a staje się elementem zarządzania firmą.
Od automatyzacji do autonomii: agenci AI w Dark Testing Factory
Piotr Zając, UiPath · 10:20
Dark Testing Factory to koncepcja autonomicznego systemu jakości, w którym agenci AI planują testy, przygotowują dane i środowiska, uruchamiają scenariusze, analizują wyniki i utrzymują testy wraz ze zmianą aplikacji. Prelekcja pokazała, jak zmienia się rola testera, gdzie nadal potrzebny jest ludzki osąd i jakie wyzwania niosą niedeterminizm, halucynacje i regresje modeli.
Zarządzanie jakością w dużej organizacji. Trzy nowe fronty: AI, bezpieczeństwo, dostępność
Tomasz Stelmach, Quality Island · 11:00
AI przyspieszyła pisanie kodu, ale nie jego sprawdzanie. NIS2 i KSC przenoszą odpowiedzialność za bezpieczeństwo na zarząd i łańcuch dostaw, a Europejski Akt o Dostępności zamienił dostępność cyfrową w obowiązek prawny. Na przykładach z ponad 150 projektów Quality Island prelekcja pokazała, jak zarządzać tymi trzema frontami jednym systemem: dlaczego firmy utykają na pilocie AI, jak przenieść bezpieczeństwo z pentestu do Definition of Done i gdzie w organizacji wpisać dostępność. Na koniec pięć pytań do zadania własnemu zespołowi QA.
Your Spec Can Write Your Code
Artur Ziółkowski, Senior Tester · 11:55
Przez lata specyfikacje były dokumentacją, a źródłem prawdy był kod. Specification Driven Development odwraca ten porządek: punktem wyjścia jest precyzyjna specyfikacja, z której z pomocą AI powstają kolejne elementy rozwiązania. Na przykładzie projektu REST API prelegent pokazał, co to oznacza dla ról, procesów i codziennej pracy w IT.
Dlaczego testerzy nie testują dostępności i jak to zmienić w 30 dni
Kinga Witko, Tu się testuje · 12:35
Większość testerów wie, czym jest dostępność, wielu zna podstawy WCAG, a mimo to dostępność nie trafia do codziennych testów. Problemem nie jest brak wiedzy, tylko brak podejścia, które da się zastosować w projekcie. Prelekcja pokazała prosty, powtarzalny proces testowania dostępności i sposób, by zrobić z niej przewagę jakościową i biznesową produktu.
Testować, czy nie testować: oto jest pytanie (do agenta). Jak Claude Code, Playwright i AI zmieniają codzienność testera
Arkadiusz Jelonek, Testing Station · 14:30
Jeśli test E2E albo API pisze się trzy minuty zamiast godziny, zmienia się ekonomia całej automatyzacji. Prelegent pokazał pisanie testów Playwright z Claude Code, własne skille pod projekt i agentów wykonujących zadania. Była też uczciwa część: gdzie AI ściemnia, gdzie się zapętla, co kosztowało pół dnia debugowania i kiedy lepiej mu nie ufać.
Model AI to tylko silnik, a Ty potrzebujesz kompletnej maszyny. O efektywnym wykorzystaniu AI w testach automatycznych
Krzysztof Kijas i Przemysław Barański, jaktestowac.pl · 15:10
Najmocniejszy model to jak silnik z bolidu F1 w przeciętnym aucie: może być szybko, może być drogo, ale nie musi być skutecznie. O wyniku decyduje cała maszyna, czyli kontekst, prompt, narzędzia i walidacja. Prelegenci pokazali, jak dobierać model do zadania, od prostego commita po generowanie testów E2E, gdzie AI przepala tokeny i budżet oraz jak liczyć koszt pracy z AI, gdy przechodzi ona z fazy eksperymentu w koszt operacyjny.
Late Security = Expensive Security. Dlaczego bezpieczeństwo musi zacząć się przed pentestem
Rafał Krząpa, Euvic i dlaTesterow.PL · 15:50
Pentest powinien weryfikować bezpieczeństwo, a nie być momentem, w którym zespół zaczyna o nim myśleć. Prelekcja pokazała, jak włączyć bezpieczeństwo w cały cykl wytwarzania: threat modeling, regularne sprawdzanie autoryzacji, kontroli dostępu i walidacji danych w codziennych testach QA. Były też realne przykłady kosztów dużych zmian po pentestach i podatności, które mogły dotknąć klientów na produkcji.
Sala 2
Historia o tym, że testy E2E nie zawsze muszą wyglądać tak samo
Łukasz Eich, Alior Bank · 09:40
Zmienne wymagania, goniące terminy i nagła transformacja zespołu, w której testerzy manualni z dnia na dzień zaczynają automatyzować przy minimalnym czasie na mentoring. Zamiast narzekać na warunki, zespół nagiął zasady. Prelekcja o tym, że w testach E2E kreatywność bywa ważniejsza od sztywnych wzorców projektowych.
WCAG 2.2: nowa „Dziewiątka” w arsenale testera
Agata Rudzka, Smartware · 10:20
Dziewięć kryteriów sukcesu WCAG 2.2, które najbardziej zmieniają doświadczenie użytkowników mobilnych i osób z ograniczeniami poznawczymi. Prelegentka pokazała, jak w 30 minut, bez pisania skryptów, sprawdzić znikający focus, za małe przyciski czy blokadę wklejania haseł, i jak włączyć testy dostępności w testy eksploracyjne i zadania w Jirze. Uczestnicy dostali checklistę „na jutro”.
What masters do to become masters?
Katarzyna Nowakowska, Sabre Polska · 11:00
Prelekcja o anatomii wybitności bez mitu wrodzonego talentu: celowa praktyka, wytrwałość, projektowanie otoczenia tak, żeby konsekwencja stała się nawykiem, i traktowanie porażki jak chłodnego feedbacku. Konkretny plan na długodystansową odporność zamiast czekania na motywację.
Stabilne testy na bramkach w dobie agentów AI
Mateusz Bator i Wojciech Biskowski, Comarch · 11:55
Zły kod zawsze pozostanie złym kodem, a w dobie AI powstaje go więcej i szybciej trafia na bramkę jakości. Prelegenci opowiedzieli, jak procesowo stabilizują testy, zanim trafią na bramki, czym ich Repeat różni się od Retry w Playwright oraz jak agenci do code review odsiewają flaky testy przed mergem i pomagają analizować błędy z raportów.
Sztuka projektowania zaufania. Czy czeka nas koniec deterministycznych testów?
Radosław Wasik, rwasik.pl i STATSCORE · 12:35
Agentic Testing to podejście, w którym testy działają bliżej intencji użytkownika i celu biznesowego niż struktury interfejsu. Na przykładzie prelegent pokazał, jak agent AI adaptuje się do zmian w UI i współpracuje z klasycznymi testami tam, gdzie determinizm nadal ma sens. Najważniejsze było budowanie zaufania: mierzenie stabilności wyników, guardrails i moment eskalacji do człowieka.
AI w dostępności: niebezpieczny audytor czy genialny asystent? Przegląd możliwości bez lukrowania
Emilia Krzemińska-Komenda, Hicron · 14:30
Automatyczne narzędzia wykrywają około 30 procent błędów dostępności, więc AI kusi jako sposób na resztę. Prelekcja zamieniła hurraoptymizm na chłodną analizę scenariuszy: AI dobrze tłumaczy żargon i pomaga przy tekstach alternatywnych, ale nie nadaje się na ostatecznego sędziego zgodności. Wsparcie, a nie zastępstwo dla wiedzy eksperta.
Page Object Model: świadoma decyzja czy dziedziczony nawyk?
Artur Duziak, SoftAvail · 15:10
POM to domyślny wzorzec w prawie każdym projekcie testowym, tylko ilu z nas świadomie go wybiera? Prelegent skonfrontował argumenty przeciw POM z zasadami DRY, WET i AHA i pokazał na przykładach w Playwright i TypeScript, kiedy abstrakcja utrudnia czytanie i utrzymanie testów. Lekcja krytycznego myślenia w czasach, gdy AI coraz częściej podejmuje decyzje za nas.
How Microsoft Copilot Transforms QA Workflow: Practical Insights from Daily Use
Halyna Muryniuk, EPAM · 15:50
Prelekcja po angielsku o tym, jak Copilot wspiera myślenie w manualnym QA, a nie tylko przyspiesza rutynę: pomaga odkrywać ukrytą logikę systemu, kwestionować założenia produktowe, wskazywać ryzyka regresji i wzmacniać testy eksploracyjne. AI jako partner do myślenia dla doświadczonych testerów.
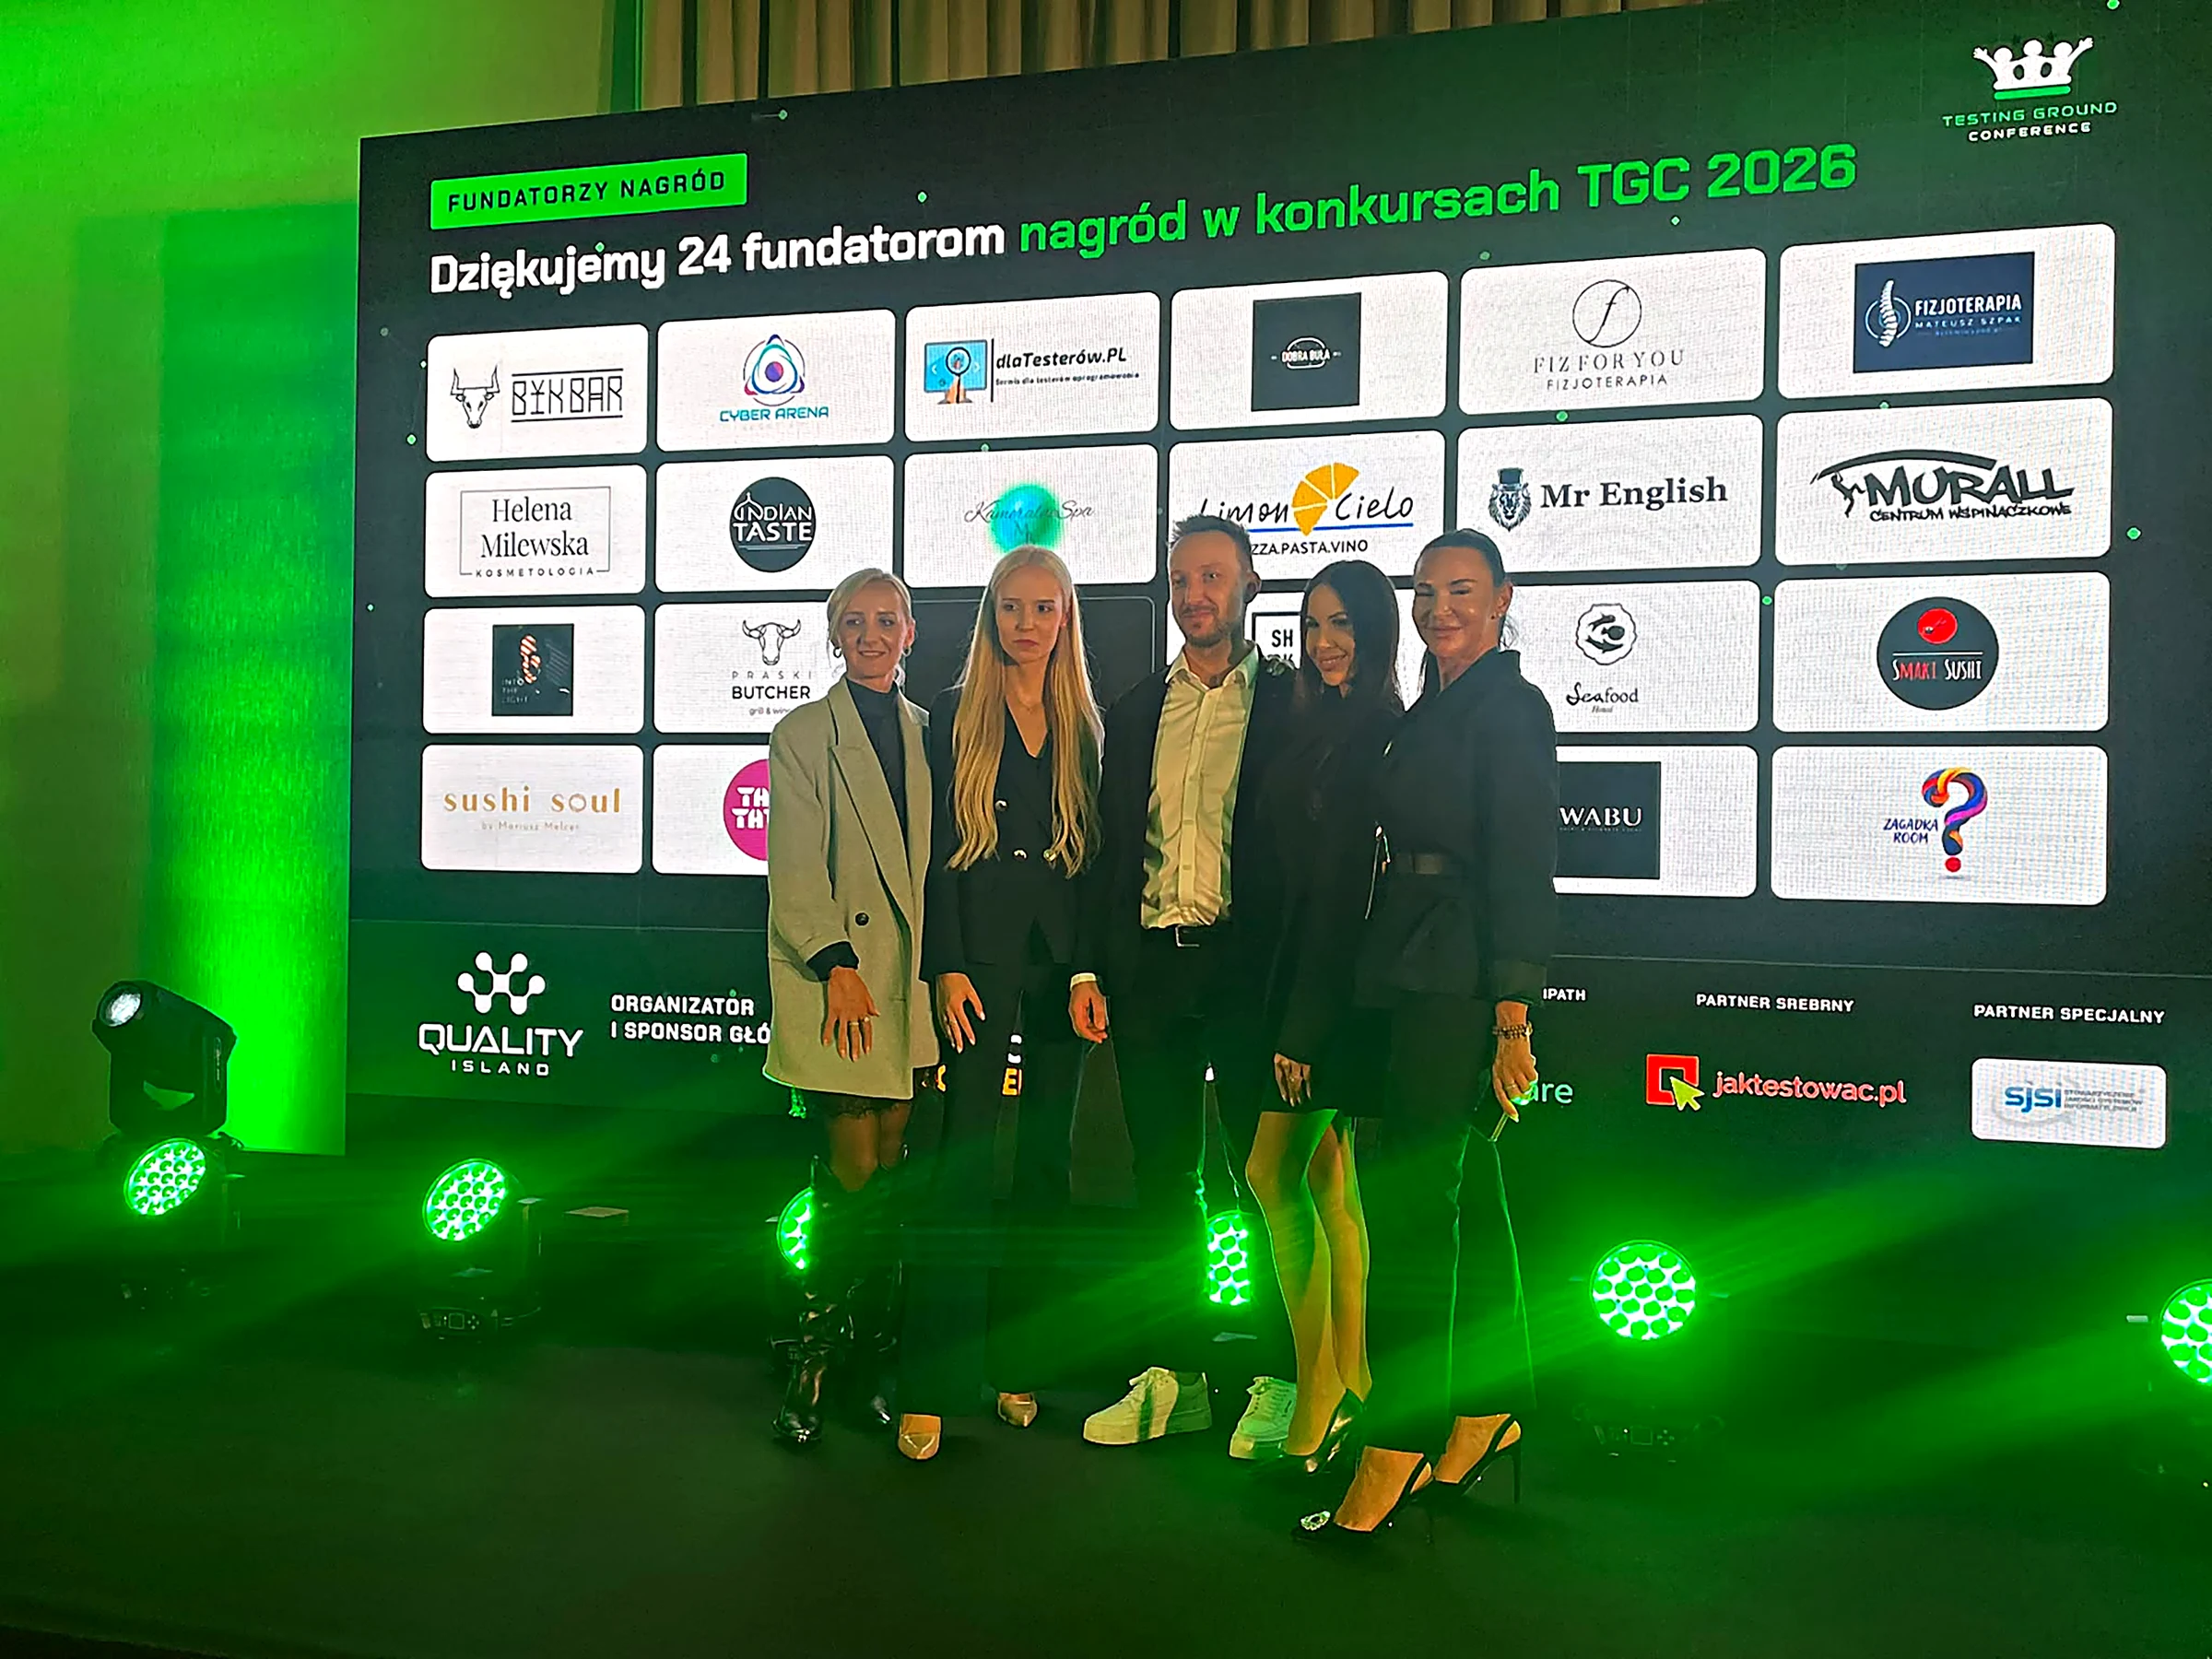
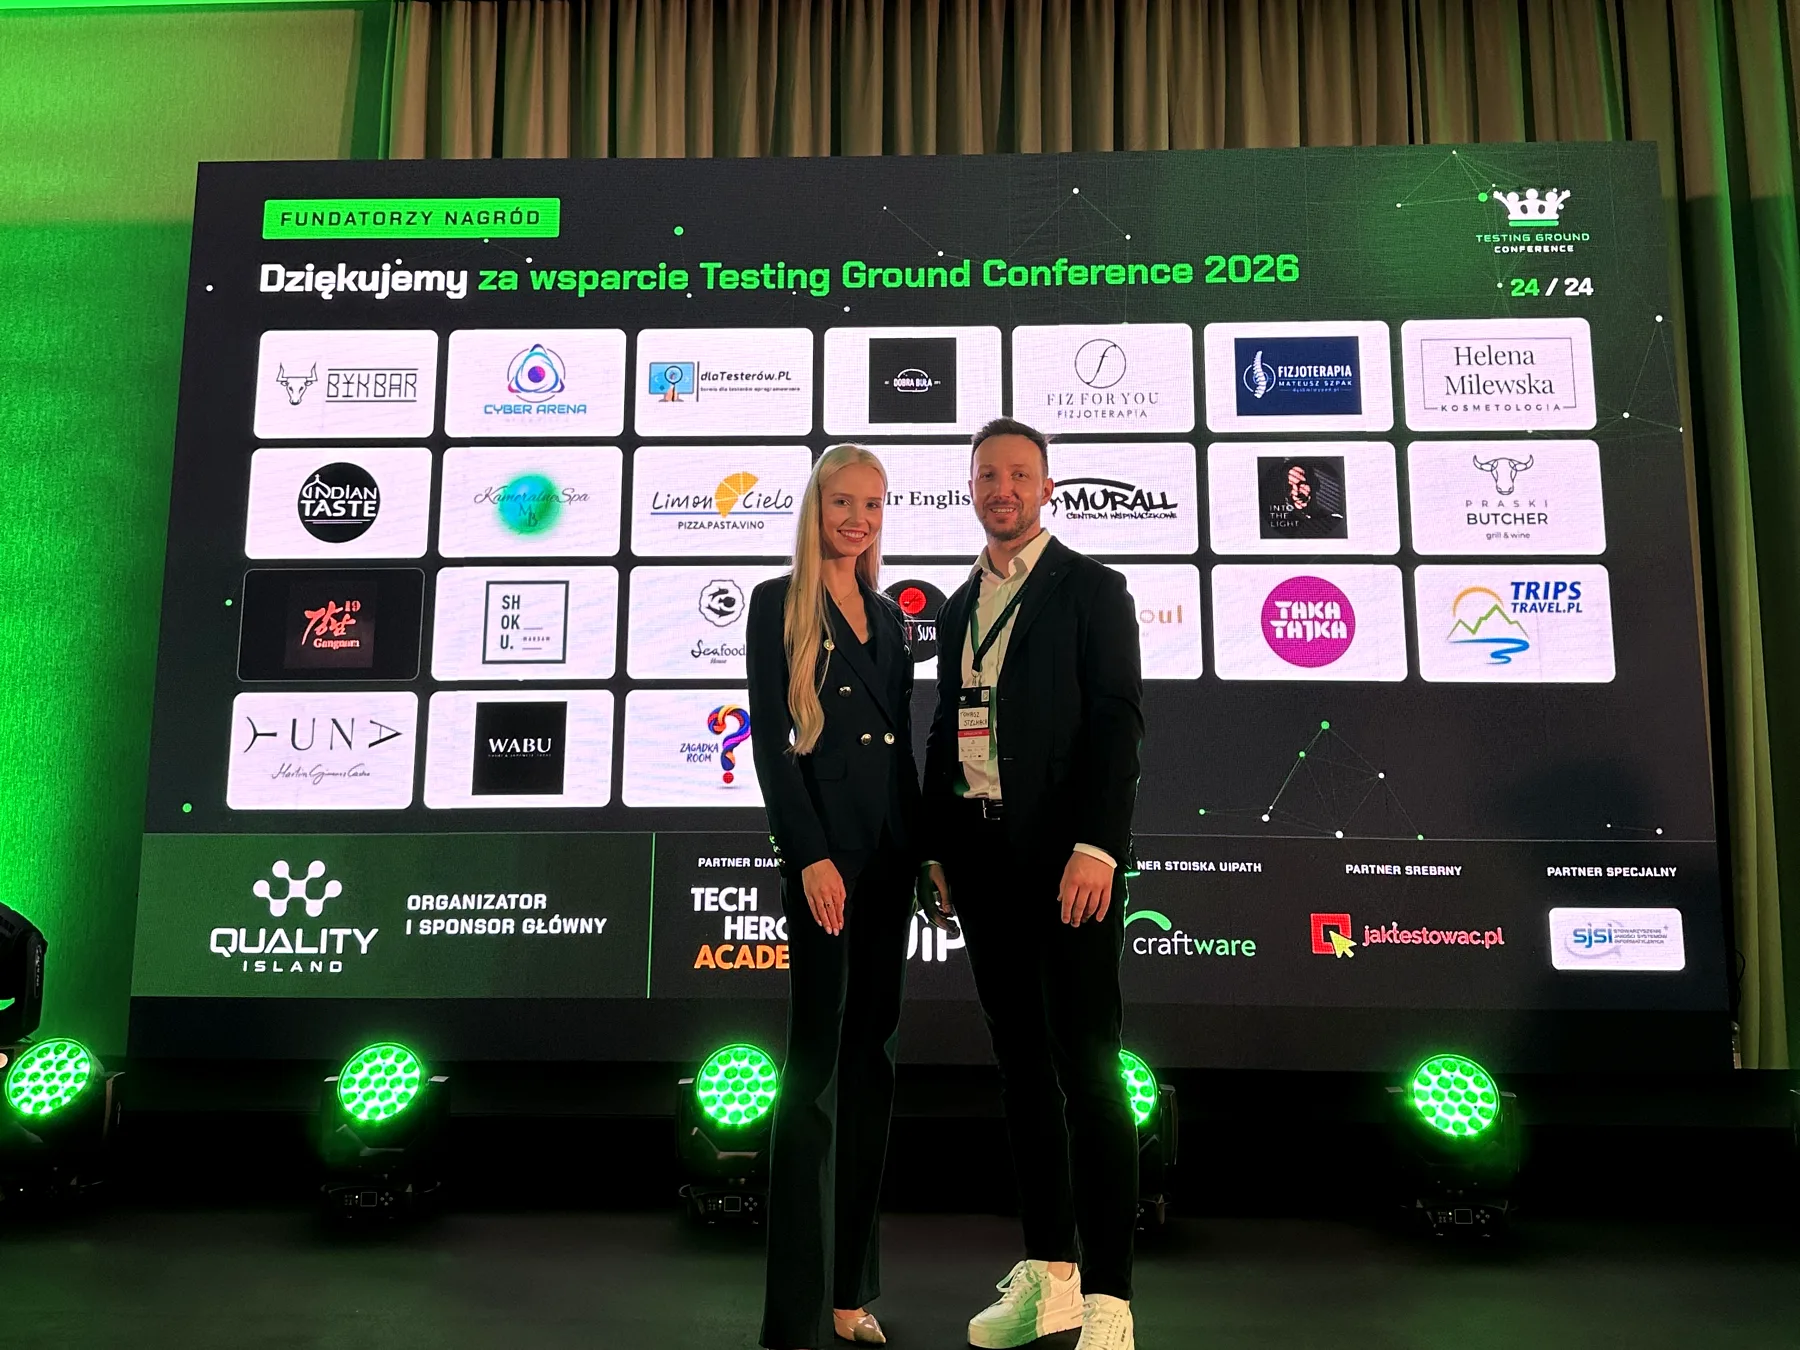
Dzień zakończyło rozstrzygnięcie konkursów i wręczenie nagród. Dziękujemy wszystkim fundatorom, którzy razem z nami stanęli na scenie.
Kto stoi za Testing Ground Conference
Za konferencją stoi Tomasz Stelmach, CEO i założyciel Quality Island, czyli firmy, która jest organizatorem i sponsorem głównym Testing Ground Conference. Testowaniem i jakością oprogramowania zajmuje się od ponad 15 lat, a konferencję organizuje razem z Dominiką Stelmach. Testing Ground powstał z prostej potrzeby: polskie środowisko QA zasługuje na wydarzenie, na którym praktycy rozmawiają z praktykami, a liderzy jakości z decydentami IT.
Tomasz jest nie tylko gospodarzem, ale też prelegentem i ekspertem, który na co dzień pracuje z zespołami QA. W tegorocznej edycji mówił o zarządzaniu jakością w dużej organizacji i o trzech nowych frontach: AI, bezpieczeństwie i dostępności. Prowadzi jeden z największych profili QA w Polsce, z ponad 25 000 obserwujących na LinkedInie, a w Quality Island przeprowadził ponad 40 wdrożeń AI w firmach i dużych organizacjach.
Quality Island, którą kieruje, to firma wyspecjalizowana w testach i jakości oprogramowania: audyty QA, automatyzacja testów, testy bezpieczeństwa i dostępności oraz najszersza oferta szkoleń QA w Polsce. Zespół jest certyfikowany ISTQB, a firma jest akredytowanym dostawcą szkoleń ISTQB. Więcej o tym, jak pracujemy z zespołami, znajdziecie na stronie Quality Island.
Co wynosimy z edycji 2026
Po dwóch dniach rozmów zostaje kilka wniosków, które przydadzą się każdemu zespołowi QA, niezależnie od tego, czy był na konferencji.
- Jakość to decyzja zarządu, nie tylko zespołu QA. AI przyspiesza pisanie kodu, regulacje przenoszą odpowiedzialność za bezpieczeństwo i dostępność na kierownictwo, więc o poziomie jakości decyduje dziś cała organizacja.
- Zaufanie do AI trzeba zaprojektować. Guardrails, mierzenie stabilności i jasna granica eskalacji do człowieka wracały w sesjach o agentach częściej niż nazwy narzędzi.
- Kontekst wygrywa z mocą modelu. Dobrze opisany projekt i świadomie dobrany model dają więcej niż najdroższa subskrypcja użyta do wszystkiego.
- Stabilność testów to proces, nie przycisk Retry. Bramki jakości, review pod kątem flaky testów i szybki feedback w CI/CD przewijały się przez obie sceny.
- Bezpieczeństwo i dostępność wchodzą do Definition of Done. Najdroższy jest błąd znaleziony tuż przed wdrożeniem, niezależnie od tego, czy to podatność, czy bariera dostępności.
- Tester zostaje osobą, która ocenia. Im więcej kodu i testów generuje AI, tym bardziej liczy się umiejętność zadania właściwego pytania i oceny, czy odpowiedź jest dobra.
Jeśli temat dostępności dotyczy Waszego produktu, warto zacząć od rzetelnego przeglądu stanu obecnego. Na stronie Quality Island opisaliśmy, jak wygląda audyt WCAG 2.2 i co zawiera raport, łącznie z deklaracją zgodności.
Testing Ground Conference 2027: do zobaczenia w maju w Warszawie
Pracujemy już nad kolejną edycją. Testing Ground Conference 2027 odbędzie się w maju 2027 roku w Warszawie. To największe dwudniowe wydarzenie z obszaru jakości oprogramowania w Polsce, na które przyjeżdżają setki uczestników i setki firm. Zapraszamy zarówno zespoły testerskie, jak i osoby decyzyjne: szefów działów testów i jakości oprogramowania, CTO i liderów odpowiedzialnych za produkty cyfrowe, dla których jakość, bezpieczeństwo i dostępność są częścią strategii firmy. Sprzedaż biletów ruszy w listopadzie 2026, a dokładną datę i miejsce ogłosimy na testingground.pl.
Chcecie wystąpić na scenie albo zostać partnerem edycji 2027? Napiszcie na kontakt@testingground.pl. Wszystkie relacje z edycji 2025 i 2026 znajdziecie w galerii konferencji.
Maj 2027, Warszawa. Sprzedaż biletów rusza w listopadzie 2026.